Qwen-Image-2.1 vs closed models: vendor benchmarks і production-перевірка bulk-каталогів у Bubble
Qwen-Image-2.1 відкрили ваги 20 вересня 2026 — але aggregate score на слайді не каже, чи витримає ваш SKU-набір. Які claims перевірити локально, як тримати prompts фіксованими в A/B через BIAIG batch і чому ліцензія Qwen Research License — окремий gate для paid Bubble.
Чому зараз
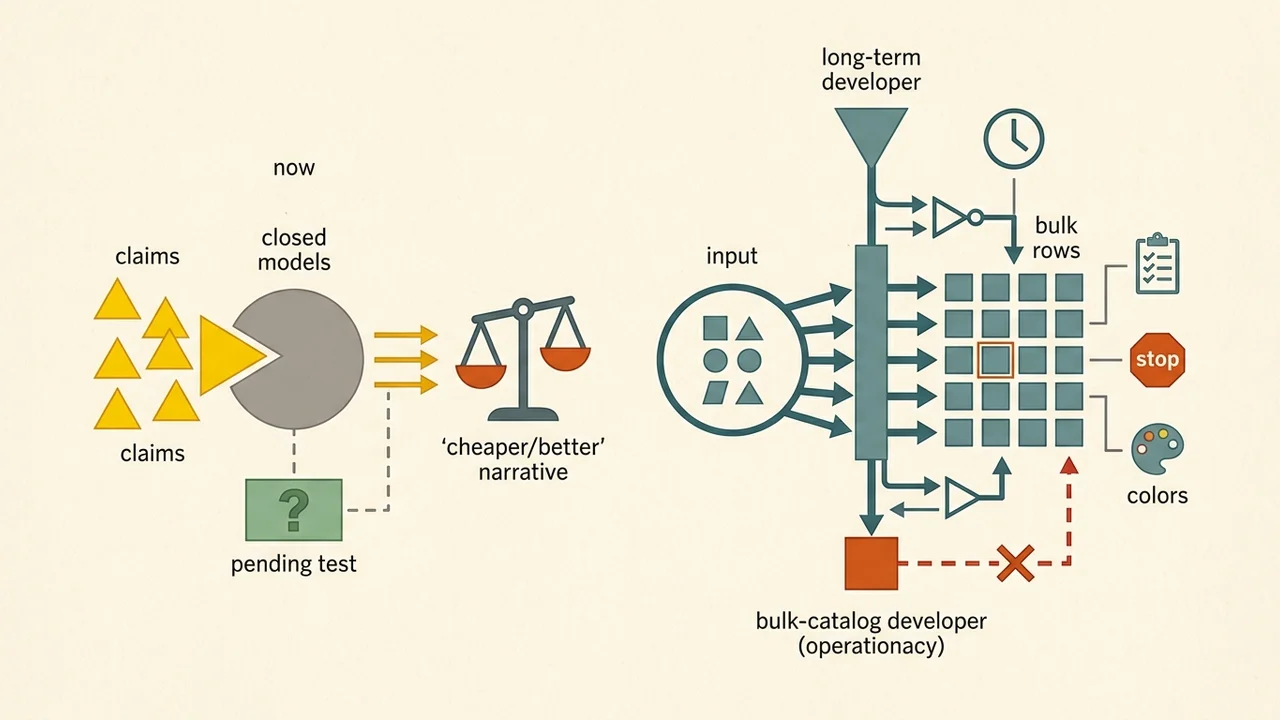
У digest зафіксовано Qwen vendor benchmark claims проти closed models при pending independent tests. Наратив «дешевше/краще» формується до того, як команди зафіксують провайдера на рік. Для Bubble-розробника з bulk-каталогом (сотні рядів, однакові правила промптів) питання не «хто на слайді», а consistency, failure rate і RGBA на ваших SKU. Про це окремо: AI кодинг для Bubble: ai.
Що саме випустили (факти з Scout packet)
Qwen-Image-2.1 (2026-09-20): unified text-to-image + image-editing; візуальний генератор описують як 7B (32 single-stream DiT layers), native RGBA, до 10 reference images, local edits, пресети aspect ratio до ~2K. Ваги й код — GitHub / Hugging Face / ModelScope; day-zero інтеграції згадують Diffusers, ComfyUI, vLLM-Omni, SGLang.
Ліцензія: Qwen Research License (не Apache 2.0, як у ранніх Qwen-Image). README і model card на Hugging Face прямо кажуть: commercial deployment потребує окремої commercial license — це hard stop для monetized Bubble apps і client deliverables, не «деталь у футері».
Операційний footprint: 7B — лише частина стеку; у вторинних production-оглядах згадують ~33GB BF16 (gen + Qwen3-VL 8B + VAE). «Open = дешево» без вашого калькулятора — claim, не факт.
Vendor benchmark: що можна взяти, а що ні
Якість позиціонують через Qwen-Image-Bench: ~1000 bilingual prompts, 56 facets, п’ять L1 pillars; judge — Q-Judger (open toolkit на GitHub / arXiv). Це reproducible toolkit, але оцінка йде через vendor judge — independent human arenas на момент Scout pass не показували Qwen-Image-2.1 (на Artificial Analysis text-to-image arena були інші Qwen SKU, не 2.1).
Треті сторони переписують launch chart: Qwen-Image-2.1 ~60.28 overall — перше серед listed open-weight, нижче шести closed (top cited: GPT Image 2.5 Sunburst ~67.01) і нижче Qwen Image 3 Pro (~62.36). Відрив від Nano Banana 2.0 / GPT Image 1.5 на тому ж chart часто менше одного пункту — порядок легко зміниться від settings і prompt rewrite.
Практичний висновок для Bubble: слайд «beats closed models» залежить від framing (шість closed все ще вище на тому ж графіку). До independent reproduction на тому ж prompt set, steps, resolution, rewriter on/off — це vendor narrative, не ваш production sign-off.
Benchmark slide ≠ bulk-каталог у Bubble
Aggregate score не міряє:
- per-SKU variance (однаковий prompt — різний продукт на рядку 47);
- retry storms і API timeouts у workflow з 500+ items;
- alpha-channel QA (halos, compression, CDN/browser у Bubble frontend);
- text-on-packaging і fidelity під ваш бренд-гайд.
Для e-commerce bulk validation фіксуйте prompts (і optional PE-T2I / PE-I2I rewriter — окремий switch у A/B), seeds / steps / resolution, один і той самий SKU/prompt batch, і порівнюйте провайдерів на pass rate, не на одному hero image.
Рамка перевірки claims на власному SKU-наборі
- Licensing gate — чи дозволено commercial use для вашого Bubble app? Без agreement — не A/B, не pilot у prod.
- Inference path — self-host vs hosted API: latency, SLA, cost на ваш batch size (не на 7B label).
- Transparency — чи native RGBA реально проходить ваш pipeline (export → storage → responsive image у Bubble)?
- Editing — local edits + refs: чи зменшують manual rework на problematic SKUs?
- Consistency — % rows без retry, % відхилень від reference, blind review на random sample (напр. 30 SKU × 3 seeds).
Claims з digest перевіряйте тільки на цьому чеклісті; chart scores — максимум гіпотеза для shortlist.
A/B через BIAIG batch без зміни prompts
Editorial brief посилається на in-house BIAIG batch: один batch run, ті самі stored prompts у Bubble, зміна лише provider / model endpoint. Публічної документації BIAIG Scout не знайшов — трактуйте як internal pattern, не як зовнішній стандарт.
Мінімальна дисципліна A/B:
- Frozen prompt table — жодних «покращень» тексту між arms;
- Rewriter control — якщо Qwen route вмикає official prompt rewrite, те саме правило (on/off) для closed arm або явно дві підгрупи;
- Identical render params — resolution, steps, aspect preset з вашого каталогу;
- Same SKU keys — pairing по product_id, не по «схожих» продуктах;
- Metrics — pass/fail rubric (fidelity, text legibility, alpha clean, brand color), не aggregate bench score.
Результат A/B — таблиця «provider × failure mode», яку можна обговорити з клієнтом без hype.
Open questions (чесно залишаємо відкритими)
- Чи відтворив хтось launch row для 2.1 через Qwen-Image-Bench prompts + Q-Judger на тих самих closed API settings?
- Коли 2.1 з’явиться на independent preference arenas і як Elo співвіднесеться з Bench totals?
- Commercial license: terms, pricing, latency для hosted Qwen vs self-host для вашого обсягу?
- Чи PE rewriter матеріально змінює outcomes vs raw Bubble prompts?
Bottom line
Qwen-Image-2.1 — цікавий open-weight кандidate з RGBA і unified edit, але vendor benchmark + Q-Judger ≠ ваш bulk catalog. До independent tests і власного SKU A/B (BIAIG batch, fixed prompts) — не фіксуйте провайдера на рік через slide. Спочатку license, потім pass rate на N SKU. Поруч із цим: gpt-image-1 вимикається 23.10.2026: міграція bulk-каталогів. Про це окремо: SenseNova U1 Pro і 8K. Про це окремо: ComfyUI 0.40 і Qwen-Image 2.1.
Джерела: Scout packet (GitHub README Qwen-Image-2.1, Hugging Face model card, Alibaba Cloud launch post, Qwen-Image-Bench paper/repo, Artificial Analysis arena snapshot, вторинні огляди Cellcog/Orca Router/Traictory). Не публікувати зовні.