Nano Banana 2.1: ~50% API/batch pricing (aggregator) — перерахунок mass-generation jobs для Bubble-каталогів у BIAIG
Google GA випустив gemini-nano-banana-2.1 (06.10.2026). Для high-volume каталогів у Bubble — коли залишати sync API Connector, коли переносити jobs у Batch (~24h), і що логувати per SKU для finance.
Навіщо перераховувати зараз
6 жовтня 2026 Google вивів у GA gemini-nano-banana-2.1 — наступник gemini-3.1-flash-image (Nano Banana 2). У release notes NB2 deprecated з shutdown 2026-10-29, міграція на 2.1. Поруч із цим: Gemini Nano Banana 2 у. Про це окремо: 29.10.2026: вимкнення Nano Banana 2.
Я дивився deprecations 07.10.2026 під час Scout-pass: для того ж model ID там ще було «No shutdown date announced». Не покладайтеся на одну таблицю — перед продакшен-deadline перечитайте обидва джерела (release notes, deprecations).
Агрегатори (digest, benchlm.ai) пишуть «~50% дешевше» — переважно image-output і batch = половина standard. Для 1K/2K це збігається з Gemini API pricing. 4K — standard падає ~25% ($0.151 → $0.113), не 50%. Не переносьте «−50%» на total invoice: input tokens на 2.1 вищі ($1.50 vs $0.50 per 1M на NB2), default thinking — medium, grounding може додати $14/1k search queries після free quota.
Якщо у вас у жовтні bulk-генерації для каталогу в Bubble — rebaseline unit economics до cutoff NB2, а не лише заміна model string.
Цифри, на які спирається replan (Google, paid tier)
Еквіваленти за одне зображення (image output):
| Роздільність | NB2 standard | 2.1 standard | 2.1 batch (50% standard) |
|---|---|---|---|
| 1K | $0.067 | $0.0336 | $0.0168 |
| 2K | $0.101 | $0.0504 | $0.0252 |
| 4K | $0.151 | $0.113 | $0.0567 |
Batch API: async, цільовий turnaround до 24 годин (часто швидше), документація Batch API. Image batch token rates: $15 vs $30 per 1M image tokens (standard). 2.1 не має 0.5K — якщо pipeline тягнув NB2 0.5K, доведеться upshift на 1K (cost + visual spec).
Model card: gemini-nano-banana-2.1 — Batch API supported, resolutions 1K/2K/4K.
Bubble-каталог: sync API Connector vs batch у BIAIG
Editorial inference (не з офіційного Bubble/Google spec): jobs, де сьогодні кожен SKU їде синхронно через API Connector (generateContent-style), при SLA ≥24h на оновлення зображень — кандидати на Gemini Batch, а не на ще один sync loop. Поруч із цим: Imagen 3 GA знято: міграція. Поруч із цим: Gemini Nano Banana 2 у.
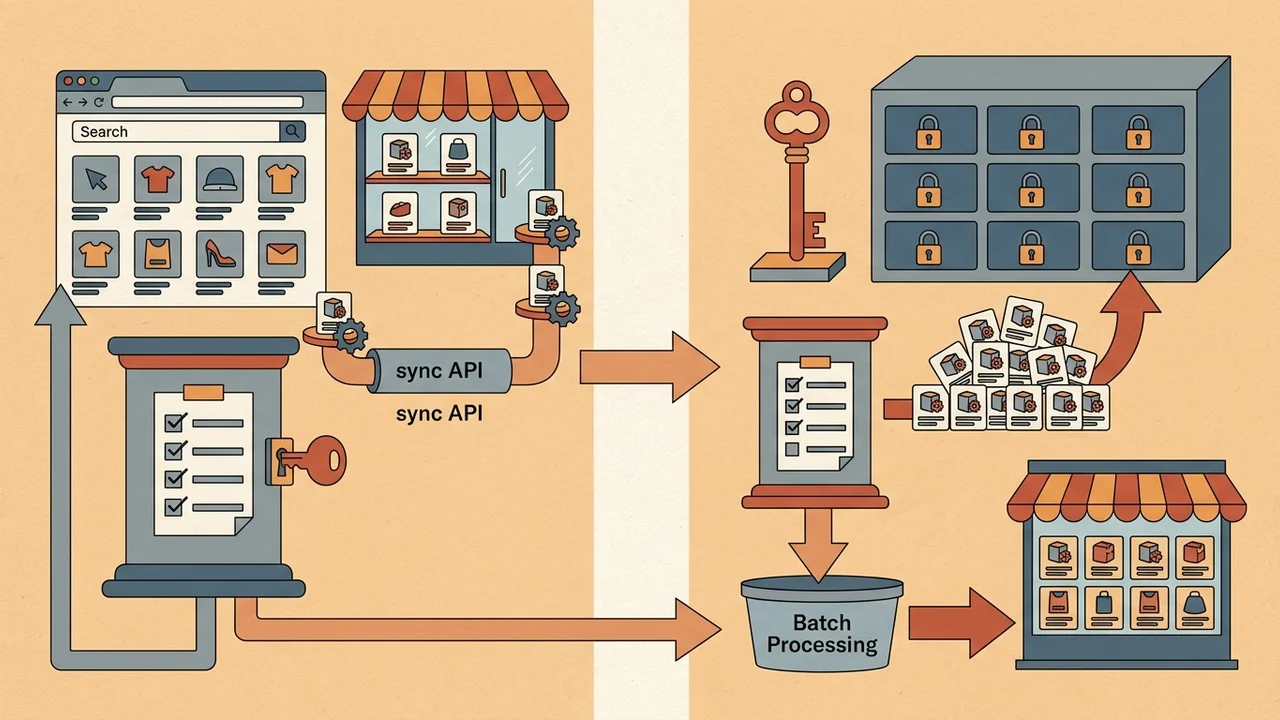
| Критерій | Sync API Connector | Batch (BIAIG / зовнішній orchestrator) |
|---|---|---|
| SLA | хвилини–години | до ~24h (best-effort) |
| Unit cost (image output) | standard rates | ~50% standard |
| Bubble WU | багато workflow runs на SKU (call + retry + save) | submit/poll/download — рідші, «важкіші» кроки; break-even по WU не задокументований — міряйте на своєму плані |
| Correlate SKU | ваш internal id у workflow | JSONL per-line user keys (Google рекомендує для mapping output) |
| Retries | ризик duplicate spend без idempotency | ті самі keys + idempotent ingest у Bubble |
BIAIG: у Scout-pass не знайшов публічної spec, як саме BIAIG збирає JSONL, submit job, poll/webhook і повертає assets у Bubble. Практично: treat BIAIG як шар, який має відповідати Generating images in batch (inline до ~20MB або JSONL до 2GB), а Bubble лишається source of truth для SKU state і publish gates.
Не мігруйте на Imagen :predict — для Nano Banana потрібні generateContent-patterns (image generation guide).
Вирівнювання scheduler і WU з batch-вікном
- Розділіть «submit day» і «publish day»: scheduler у Bubble не повинен припускати same-day completion для batch. Gate publish на статус job + наявність файлу в Storage/CDN.
- Polling: рідший poll (наприклад кожні 15–60 хв) замість tight loop — менше WU, відповідає 24h SLA.
- Catalog waves: wave = один JSONL batch з ключами SKU; не змішуйте urgent sync exceptions у той самий wave без окремого budget line.
- NB2 cutoff: до 29.10 (якщо підтвердиться у вашому project) — freeze нових NB2 jobs; regression sample NB2 vs 2.1 (edits, reference-image, text-on-image) — open question, але без цього finance-economics не рівні quality risk.
Що логувати per SKU (finance + ops)
Мінімальний набір полів (align з batch JSONL keys + invoice reconciliation):
sku_id/ catalog key (той самий key у JSONL line)model_id:gemini-nano-banana-2.1modality:standard|batchresolution:1k|2k|4kbatch_job_id,batch_line_key,submitted_at,completed_atimage_output_count,token_usage(якщо API повертає metadata)thinking_level(defaultmediumна 2.1)grounding_used/ search query count (для allocation після quota)prompt_template_id(shared templates — для split grounding/thinking по SKU)google_invoice_line_refабо export row idretry_generation_id(idempotency — не платити двічі за один SKU у одному wave)
«~50% cheaper» у заголовках digest не замінює рядок input + thinking + grounding у вашому spreadsheet — я так і рахую invoice.
Джерела (межі статті)
- Gemini API pricing — primary для цифр
- Batch API
- Nano Banana 2.1 model card
- Aggregator benchlm.ai — cross-check; 4K там може не збігатися з Google — у replan використовуйте Google footnotes
Стаття internal editorial; не публікується зовні. Scout packet only — без додаткового web pass.