GPT Image 2.5: 250 IPM без Batch API — capacity-план bulk-каталогів у Bubble через BIAIG
Як зіставити опубліковані IPM OpenAI, паралелізм Bubble і chunking таблиць, коли для 2.5 ймовірний лише sync-шлях — без вигаданих SLA і з чесною невизначеністю щодо Batch.
Контекст
У digest зафіксовано: GPT Image 2.5 (gpt-image-2.5-flare, gpt-image-2.5-sunburst) на верхньому usage tier дає до 250 images per minute (IPM), а Batch API для 2.5 на практиці не варто планувати як основний маршрут — сторінки моделей показують batch endpoint у chrome, але офіційний Batch guide вимагає перевірки per-model, а сторонні огляди (LaoZhang, вересень 2026) стверджують, що batch-ціноут для images лишає gpt-image-2, не 2.5. Це не абсolut: перед продакшеном варто один контрольний JSONL-тест або матрицю моделей у OpenAI.
Для bulk-каталогів у Bubble (оркестрація через BIAIG — editorial context; публічної документації під цим acronym Scout не знайшов) sync Images API стає capacity-задачею, а не лише питанням промпта. Поруч із цим: gpt-image-1 вимикається 23.10.2026: міграція bulk-каталогів. Поруч із цим: Batch API до 50k запитів. Схожий розбір: Fozzels (жовтень 2026): ліміти Image. Схожий розбір: Krea 3 Ultra: 2K-edits і.
Що саме обмежує (за OpenAI)
На сторінках Flare/Sunburst однакова таблиця tier → 5 / 20 / 50 / 150 / 250 IPM (і відповідні TPM). OpenAI підкреслює: RPM, TPM, IPM можуть б’ути незалежно; ліміти org/project; моделі можуть ділити пул; при 429 — Retry-After, backoff з jitter, відрізняти rate limit від quota/billing.
Параметр n (1–10) дає кілька зображень на один HTTP-запит, але не обходить IPM і може посилити burst, якщо команда плутає «запити» з «готовими рядками каталогу».
Практична змінна (inference, не SLA):
effective throughput ≈ min(IPM, concurrency_adjusted_for_latency, TPM_if_heavy) − retries − moderation − duplicate_after_timeout
Сторонній Atlas Cloud (вересень 2026) радить планувати порядку ~100 «usable» images з дисципліною черги та бюджетом rework — не прирівнювати tier IPM до доставлених рядків таблиці.
Bubble: паралелізм ≠ IPM
Публічно Bubble не публікує фіксовану кількість одночасних API workflows. Schedule API workflow on a list може стартувати багато job паралельно (не всі одразу); interval зменшує overlap, але не гарантує сувору серіалізацію. Hard limit: 300 s на workflow.
Документація Bubble прямо рекомендує intervals, щоб захищати rate limits третіх сторін — тобто «розмазати 500 рядків list schedule без admission control» часто означає 429/slow_down на OpenAI, а retry-storm ще й їсть limit budget (OpenAI).
Editorial constraint ~500 рядків на chunk у bulk-tools — внутрішній/продуктовий контекст, не hard limit Bubble (у docs — до 100k schedulable items на unsorted list). Використовуйте chunk як операційний безпечний розмір, не як доказ «Bubble дозволяє лише 500».
Capacity-план для BIAIG (sync 2.5)
1. Визначити binding constraint
- Перевірити реальний tier IPM у dashboard (може ≠ таблиці на model page).
- Оцінити latency одного image call (variant/quality) — без ваших замірів concurrency лишається guess.
- Якщо промпти/token-heavy — перевірити TPM.
- Під навантаженням: що впирається першим — OpenAI IPM, Bubble scheduler congestion, Workflow API RPM (plan-dependent)? Про це окремо: Bubble для фаундера: чеклист bubble.io.
2. Admission control у workflow
- Не 1:1 «рядок таблиці → миттєвий image call без throttle».
- Патерни: interval на list schedule; semaphore (Thing/counter «in flight»); recursive chunking (100–500 рядків + resume state).
- Idempotency: після timeout не дублювати submission без перевірки статусу рядка.
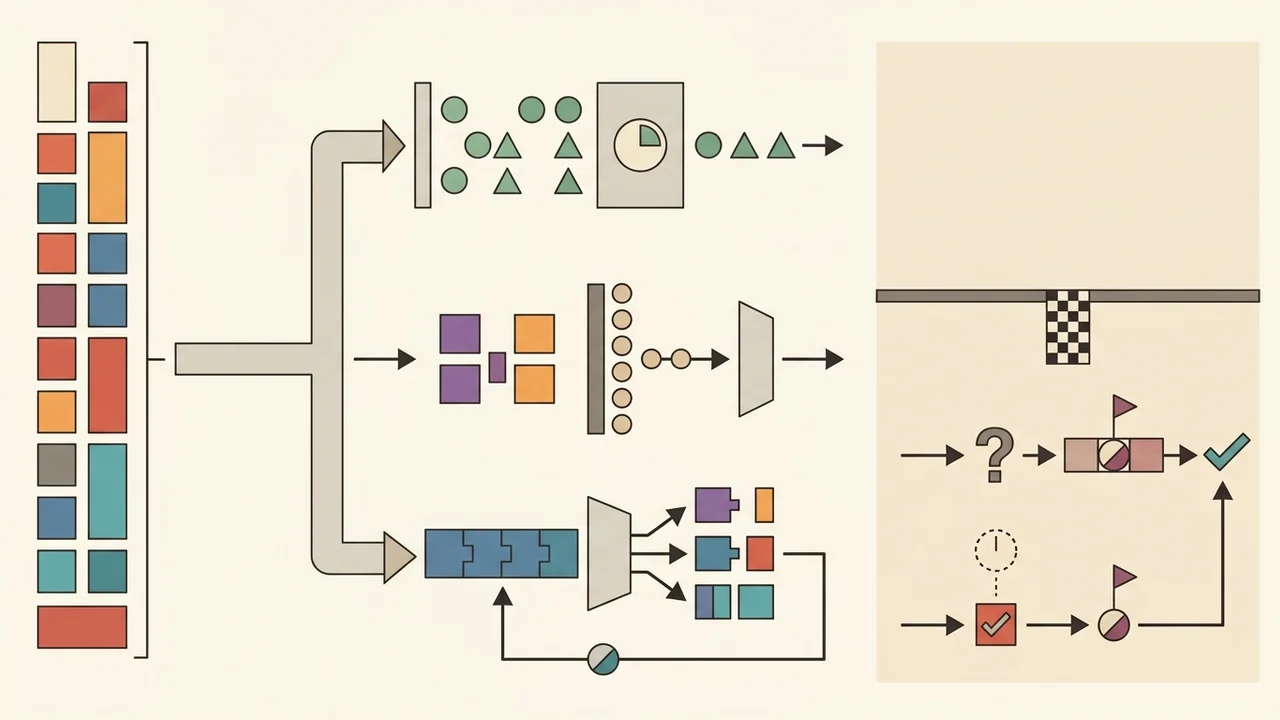
3. Retry policy (з Scout + community summary OpenAI classes)
- Retry: transient 429 / overload з
Retry-After. - Не auto-retry: quota/billing,
moderation_blocked,image_generation_user_error— інакше rework budget і черга «з’їдять» вікно.
4. Fallback-маршрутизація (коли batch для 2.5 недоступний)
| Маршрут | Коли | Tradeoff |
|---|---|---|
| 2.5 sync + IPM queue | Same-session каталог, потрібна Flare/Sunburst | Повна ціна sync; жорсткий IPM cap |
gpt-image-2 Batch |
Overnight / cost-insensitive volume | −50% cost (Batch guide), до 24 h completion, одна модель на JSONL — не same-session UX без async status у продукті |
| Інший provider через BIAIG | Overflow | Лише якщо BIAIG реально expose provider switch (потребує vendor docs) |
Agnostic Agents Pro на Bubble marketplace ілюструє multi-provider в workflows — аналог патерну, не підтвердження BIAIG API.
Чеклист: скільки рядків «реально» за вікно
Без гарантій SLA — лише планування.
- Опублікована стеля (якщо IPM binding):
rows_ceiling ≈ IPM × minutes_in_window— на Tier 5 це ≤ 15 000 image completions / годину лише як теоретичний max, якщо кожен success = один image і немає інших bottlenecks. - Консервативне планування (third-party framing): для операційного плану візьміть ~40% від tier IPM як «usable» орієнтир (Atlas ~100 при 250 IPM — не OpenAI офіційно); підставте ваш rework rate після першого прогону.
- Concurrency check: якщо середня latency L секунд і ви тримаєте C паралельних in-flight calls, rough bound ≤ min(IPM, 60×C/L) successful/min — поки не виміряли L, зменшуйте C.
- Bubble window: chunk ≤ ~500 рядків; між chunk — pause або cron; зберігайте resume key (row id, attempt, last error class).
- Перед релізом: один load test на 50–100 рядків → порахувати
% 429,% moderation, median latency → оновити таблицю плану.
Відкриті питання (не закривати в статті фактами)
- Batch production eligibility для
gpt-image-2.5-flare/sunburst. - Чи Flare і Sunburst ділять один IPM pool.
- Чи BIAIG підтримує Batch, async polling, multi-provider — потрібна primary vendor documentation.
Джерела (межі матеріалу)
OpenAI: model pages 2.5 Flare/Sunburst, gpt-image-2, guides Rate limits / Batch / Image generation. Bubble: Scheduling API workflows, Bulk operations compared, Hard limits, Scheduler. Планувальний колір: Atlas Cloud, LaoZhang (Batch 2.5), CometAPI community (error classes). Editorial: digest IPM/batch absence; ~500-row chunking; BIAIG as orchestration layer. Поруч із цим: OpenAI Batch API для images.