Flare, Sunburst і WaveSpeedAI: маршрутизація bulk-зображень у Bubble без втрати consistency
GPT Image 2.5 додав два API-варіанти та новий шар постачальників. Практична матриця для high-volume Bubble/BIAIG: коли Flare на OpenAI, коли Sunburst, коли WaveSpeed за ціною — і що не змішувати в одному edit chain.
Чому це зараз
У digest з’явились ChatGPT Images 2.5 (моделі gpt-image-2.5-flare і gpt-image-2.5-sunburst), масштаб >3 млрд зображень на тиждень (разом ChatGPT + GPT-Image API — не лише API) і окремо WaveSpeedAI з таблицями $/image. Це шар поверх уже відомих тем async/batch і latency: питання не «який ratio PNG», а куди слати bulk і як не зламати consistency, якщо в одному Bubble-workflow є кілька endpoint’ів. Схожий розбір: Bubble.io і bubble.io price: який. Поруч із цим: Meta Muse Image на fal.
Flare vs Sunburst на основному провайдері (OpenAI)
За публічними матеріалами (launch 2026-09-08):
- Flare — позиціонування під everyday / high-volume: заявлено до ~50% нижча latency vs Images 2.0.
- Sunburst — precision-heavy creative/editing, довший час генерації.
List price між Flare і Sunburst однаковий (token rates: $5/M text in, $8/M image in, $30/M image out на офіційному pricing). Вибір — швидкість vs edit fidelity, не «дешевша модель».
Практично для Bubble:
- Bulk text-to-image → за замовчуванням Flare (latency, IPM, об’єм).
- Hero, складний edit, multi-step refinement → Sunburst лише для явно позначених job’ів або коли Flare не проходить ваш golden-set.
WaveSpeedAI: коли дивитись на ціну
WaveSpeed — third-party host з окремими REST endpoint’ами (Flare/Sunburst × text-to-image/edit), async predict → poll, іншими іменами параметрів (resolution 1k/2k/4k, aspect_ratio vs OpenAI size, quality) і опублікованими таблицями за зображення (наприклад, text-to-image medium @1K — $0.024; Flare і Sunburst на WaveSpeed за цією таблицею однакові).
WaveSpeed явно попереджає: quality tier names не 1:1 між GPT Image 2 і 2.5 — rebaseline на medium, не переносити старі пресети вслепую.
Коли має сенс WaveSpeed для bulk:
- Потрібні передбачувані COGS за зображення і burst offload.
- Ви вже прогнали golden-set на mapped settings і прийняли visual parity (часто для bulk — лише Flare).
Коли не варто:
- Активний multi-turn edit chain — тримайте один vendor + один pinned snapshot.
- Потрібна continuity через Responses API / conversation state на OpenAI — offload ламає ланцюг.
Матриця маршрутизації (high-volume Bubble / BIAIG-стиль)
Публічної документації BIAIG у пакеті немає; правила нижче — inferred з OpenAI/WaveSpeed docs і digest. Перевіряйте на своєму connector’і.
| Сценарій | Маршрут | Чому |
|---|---|---|
| Bulk text-to-image, бренд не критичний | Flare, primary (OpenAI) | Latency, limits, один стек параметрів |
| Bulk з фіксованим $/image COGS | WaveSpeed Flare (після golden-set) | Таблична ціна; async poll у workflow |
| Multi-step edit / «той самий персонаж/фон» | Один vendor, pinned gpt-image-2.5-*-2026-09-08 (або ваш snapshot) |
OpenAI: same quality ≠ same output across models; тестуйте повний ланцюг |
| Hero / precision edit | Sunburst, той самий vendor що й наступні кроки | Не чергуйте Flare→Sunburst→інший host між кроками без тесту |
| Економія через Batch | gpt-image-2 Batch (якщо ще прийнятна якість) окремим шаром |
Інше покоління моделі — consistency trade-off; ізолюйте non-brand слоти |
| 2.5 через Batch «напівтариф» | Verify-before-production | На model pages є Batch endpoint для Flare/Sunburst, але публічне pricing/acceptance для 2.5 ID у вересні 2026 суперечливе — не закладайте 50% економії в COGS без офіційного batch row |
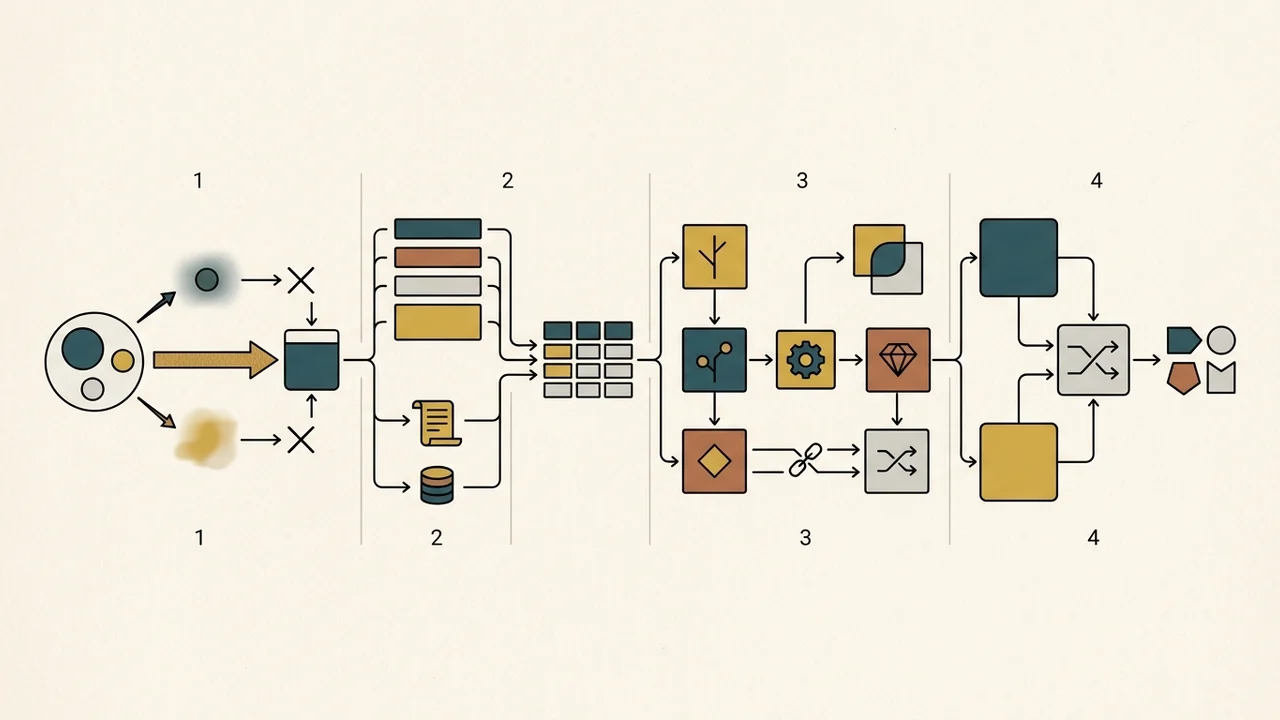
Consistency checklist (перед prod routing)
- Pin model ID (dated snapshot), не «latest» у production.
- Фіксуйте prompt, references, dimensions/quality — і логуйте vendor + endpoint у Bubble (Custom state / Thing) для кожного кроку edit chain.
- Не змінюйте vendor/model між кроками одного ланцюга; для pixel-identical regions — compositing (згідно з OpenAI image prompting guidance).
- Мапінг OpenAI ↔ WaveSpeed: окремий translation layer у API Connector (size/quality ↔ resolution/aspect_ratio); один раз задокументуйте в internal runbook.
- Прогон golden-set (ваші реальні промпти) на primary vs WaveSpeed; порівняння лише при однакових mapped tier (старт з
medium). - IPM/TPM і черги: routing — не лише ціна; при лімітах — async queue на Bubble side або offload, але не mix у одному edit thread.
- Compliance: verification для GPT Image на OpenAI; у third-party — окремо перевірте retention/region/policy.
Відкриті питання (не вигадуйте відповіді в COGS-моделі)
- Чи
/v1/batchреально приймає 2.5 flare/sunburst з документованим half-rate. - Чи WaveSpeed дає еквівалентні weights/snapshots і moderation vs direct OpenAI.
- Точний breakpoint: token billing OpenAI sync vs WaveSpeed $/image для вашого mix quality/resolution — потрібен калькулятор + ваші виміри.
Короткий висновок
Flare — default для bulk на primary; Sunburst — вузький premium для edit-heavy job’ів; WaveSpeed — опціональний шар передбачуваної ціни після parity-тестів, не заміна для multi-turn ланцюгів. Consistency дорожча за $0.024/image — плануйте vendor boundaries так само ретельно, як batch/async.