Стелю ~500 рядків у bulk-tools 2026: chunking spreadsheet-каталогів у Bubble з BIAIG
Внутрішній roundup «Bulk tools 2026» фіксує операційну стелю близько 500 рядків на batch — не як єдиний hard limit у public-доках Bubble, а як реальний орієнтир, коли sheet живить repeat groups і async API. Нижче — патерн chunking, черги, idempotency і типові розриви consistency між чанками.
Звідки береться «~500»
У затвердженому plan item і Scout packet цифра ~500 рядків приходить з внутрішнього digest roundup «Bulk tools 2026», а не з одного рядка в Bubble Manual чи BulkImagen API. Публічні джерела з Scout описують стек менших лімітів, через який chunking на ~50–500 рядків стає звичною операційною практикою для spreadsheet-каталогів, repeat groups і зовнішніх async batch. Про це окремо: SenseNova U1 Pro і 8K. Про це окремо: ChatGPT не bulk-native: де зупинити. Про це окремо: BulkImagen batch caps 10/50/100: розмір.
Не варто подавати ~500 як універсальну platform ceiling. Краще: рекомендований розмір чанка або спостереження roundup — залежно від вашого toolchain (native Bubble, EasyCSV/CSVBox, Bulk Data API, BulkImagen).
Що насправді обмежує Bubble
| Шар | Що каже документація | Наслідок для bulk |
|---|---|---|
| Make changes to a list of things | Після 100 entries дія нічого не робить (без помилки) | Front-end / один workflow на весь sheet — небезпечно |
| Workflow API — Return data | Списки в відповіді — до 50 items без пагінації / custom JSON | UI «побачив 50 — значить все ок» — помилка |
| Data API bulk create | До 1 000 records на запит, вікно обробки до 4 хв | Можна більші чанки, але timeout і «порожні» відповіді на форумі — ризик |
| Backend workflow | 300 s hard timeout | Довгі цикли в одному run — обрив |
| Schedule API workflow on a list | Великі списки (до 100 000 unsorted), interval для throttle зовнішніх API | Рекомендований bulk-шлях замість repeat-group loop |
| CSV import | Черга на тому ж scheduler, що API workflows; під навантаженням може «стояти» на 0% | Великий one-shot import — ненадійний без chunking |
Repeat group — UI + пагінація, не двигун масової обробки. Community best practice: не вантажити весь sheet у list field repeat group (Thinkpeak — не official Bubble).
Треті сторони: чому чанки часто 50–200
- EasyCSV для Bubble: bulk POST з ~50 rows, на вищих планах ~150–200+; oversized chunks → HTTP 524, ambiguous partial success.
- CSVBox (Aug 2025): batch/recursion, row limits, idempotency keys.
- Bulk Data Editor plugin: 500 records як benchmark швидкості (Bulk Data API ~5 s vs workflow ~2.5 min) — не заявлений maximum платформи.
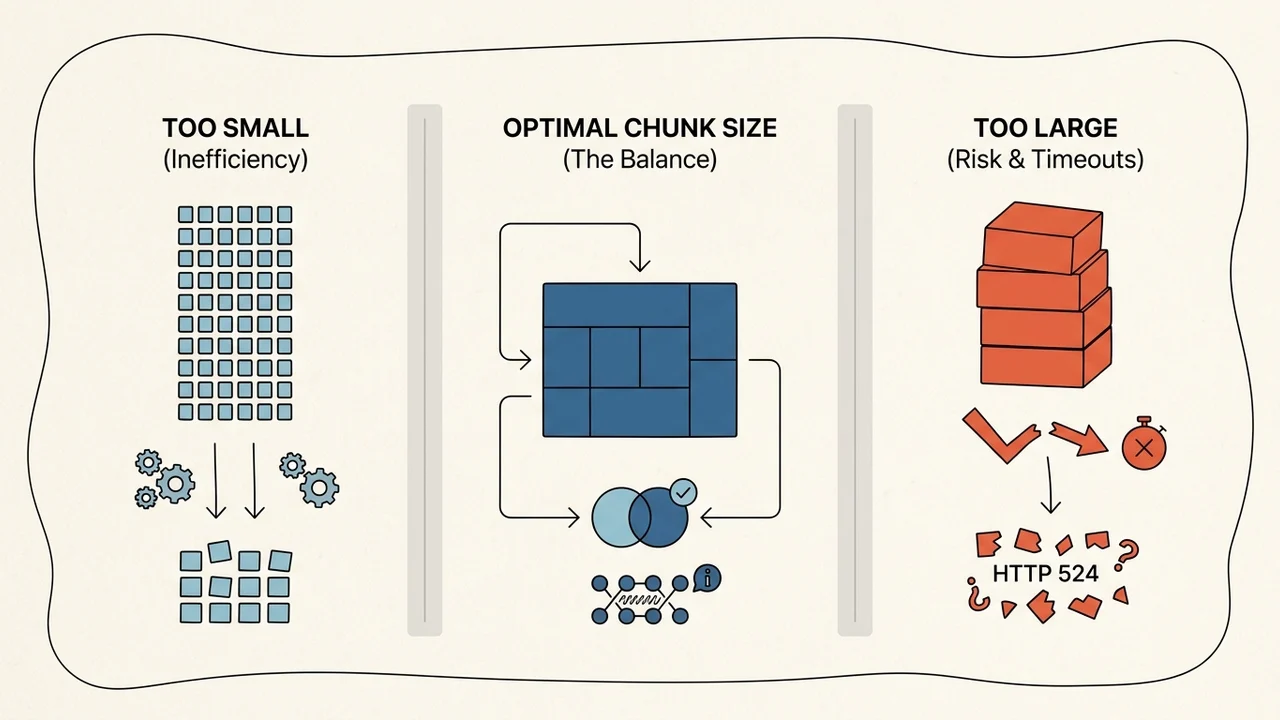
Тут ~500 з roundup накладається на benchmark-подібні сценарії, але юридично це різні джерела.
BIAIG = BulkImagen async batch у Bubble
Акронім «BIAIG» у public docs не знайдений (Scout); у статті — редакційне скорочення для інтеграції BulkImagen /v1/batches через API Connector у backend workflows (ключі не у browser — CORS заборонено). Про це окремо: AI кодинг для Bubble: ai.
Потік:
POST /v1/batches— відповідь одразу,batch_id.- Poll
GET /v1/batches/{id}покиbatch.done. resultUrls— public HTTPS; їх треба прив’язати до row key, не покладатися лише на ZIP без metadata.
Ліміти BulkImagen — не rows у sheet: images per batch (4/10/50/100 за pricing) і concurrent batches. Великий CSV-кatalog → кілька batch jobs, кожен з slice prompt list під plan cap.
refMode each і refImages з POST /v1/uploads множать billed image count — окремий джерело перерізів між «рядками в sheet» і «кредитами в API».
Патерн chunking (5 кроків)
- Stable row key на рядок каталогу: sheet row ID, SKU, campaign slug — один ключ на multi-sheet кампанію, якщо можливо.
- Import / upsert у Bubble Things NDJSON bulk чанками: ≤1000 за Data API, часто менше (50–200) через 524/timeouts.
Schedule API workflow on a list(per-row або per-chunk), з interval під rate limits BulkImagen — не front-end loop по repeat group.- Image generation: slice до plan batch size; зберігати
batch_id+ task index → row key. - Idempotent writes:
unique_key, статуси (pending/batch_submitted/url_saved/failed); retry після partial failure без дублікатів Things і без повторного списання credits на той самий batch (credits на create). Поруч із цим: Batch API до 50k запитів. Поруч із цим: OpenArt Bulk Create (500 CSV.
Де найчастіше ламається consistency між чанками
- Partial bulk import (EasyCSV 524): невідомо, які рядки в DB — потрібен reconciliation по row key.
- Retry webhook / batch без idempotency → duplicate Things (CSVBox).
- Schedule on a list: snapshot списку на момент schedule vs редагування row після — «обробили старий prompt».
- Merge poll results з кількох
batch_id: resultUrls на чужий spreadsheet row. concurrent_limit_exceeded/batch_limit_exceededmid-campaign — частина sheet «зависла» вpending.- refMode
each: очікували N images, отримали N×refs — spend і асоціації з rows роз’їхалися. - Native CSV upload (forum Dec 2025): нестабільність — recursive backend chunking як workaround.
Практичний checklist перед прогоном
- ~500 — ваш chunk size з roundup/toolchain, перевірений на staging.
- Жодного bulk «change list» >100 items.
- Row key + status на кожному Thing; blind retry заборонений без idempotency gate.
- BulkImagen: backend only; один map
task → row keyперед збереженням public URL у file field. - Після кожного чанка — count reconcile (sheet rows vs DB vs
batch.donetasks).
Джерела (межі статті)
Внутрішній Bulk tools 2026 roundup (plan item); публічно — Bubble database actions, hard limits, Data API bulk, Scheduling API workflows, BulkImagen API. Стаття не дублює unit economics gpt-image-2 batch і окремі latency/async матеріали з editorial stack — лише доповнює їх контекстом spreadsheet chunking.